사진으로 부품 살펴보기
지시만으로는 보이지 않는 물체를 알 수 없습니다
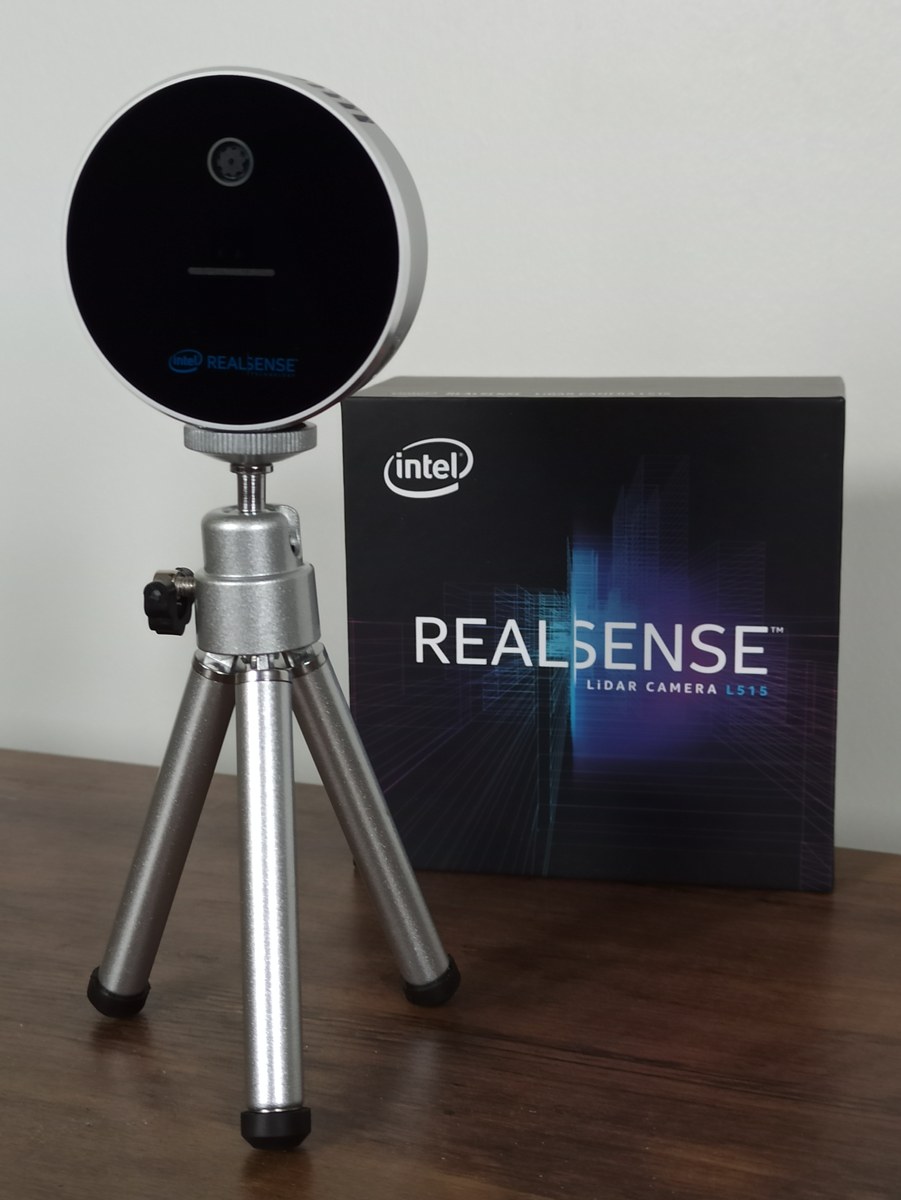
사진은 RealSense L515 깊이 카메라의 외형입니다. 아래 그림은 관측과 영상 투영을 설명하는 별도 모형이며 이 라이다 카메라의 내부 설계를 재현하지 않습니다. 카메라의 관측은 언어 지시를 실제 위치에 연결하는 단서입니다. 카메라 사진은 센서의 예이며 실제 VLA 모델의 실행 결과가 아닙니다.
라이다 방식으로 깊이를 측정하는 L515의 외형입니다. 강의의 단순 투영 계산이나 모든 로봇 카메라의 구조가 이 제품과 같다는 뜻은 아닙니다.
Marc Auledas · 원본 사진 · CC BY-SA 4.0

비율을 유지해 긴 변 최대 1200px로 축소(원본보다 확대하지 않음), JPEG 재압축 및 EXIF 제거. 추가 자르기·형태 변경 없음.
- 삼각대 위에 세운 원형 카메라 몸체를 찾습니다.
- 관측하는 앞면이 어느 쪽을 향하는지 봅니다.
- 제품 외형, 영상의 투영 원리, 깊이 측정 방식을 서로 구분합니다.
지시·관측·행동을 나누어 봅니다
이 실습은 왼쪽과 오른쪽 지시를 두 좌표에 직접 연결한 규칙입니다. 가려져 있으면 행동을 보류합니다.
- 지시: “왼쪽 상자”가 목표입니다.
- 관측: 왼쪽 상자가 보이는지 확인합니다.
- 행동: 보이면 −0.5 m로 연결하고, 가리면 멈춥니다.
실습을 처음 한다면, 이 순서대로 따라 해보세요
- 왼쪽 상자 지시와 표적이 보임을 선택합니다.
화면에서 볼 것 표적 좌표 −0.5 m와 행동 1개를 봅니다.
그 이유 지시와 실행 조건이 함께 충족됩니다.
- 같은 지시에서 표적이 가려짐을 선택합니다.
화면에서 볼 것 좌표는 같고 행동은 0개가 됩니다.
그 이유 목적지가 정해져도 관측 조건이 부족하면 보류합니다.
- 오른쪽 지시로 바꾸고 다시 표적을 보이게 합니다.
화면에서 볼 것 좌표 +0.5 m와 행동 1개를 확인합니다.
그 이유 지시 변화와 가림 변화를 따로 비교할 수 있습니다.
한 단계씩 이해하기
원리 01
문장을 아는 것과 대상을 찾는 것은 다릅니다
왼쪽이라는 단어를 알아도 누구를 기준으로 왼쪽인지 정하지 않으면 서로 다른 대상을 고를 수 있습니다. 실제 작업에는 대상의 이름, 위치 기준, 옮길 장소가 필요합니다. 짧은 지시가 자연스럽게 들린다는 이유로 모든 정보가 갖춰진 것은 아닙니다.
이 실습에서는 왼쪽과 오른쪽의 기준을 미리 고정했습니다. 왼쪽 지시는 −0.5 m, 오른쪽 지시는 +0.5 m로 연결됩니다. 좌표의 부호는 방향을 나타냅니다. 음수라고 잘못된 위치가 아니라 기준점의 반대쪽에 있다는 뜻입니다.
원리 02
볼 수 없을 때에는 무엇을 할까요
대상을 가렸는데도 이전에 있던 자리로 손을 보내면 물체가 이동한 사실을 놓칠 수 있습니다. 실제 로봇은 관측의 신뢰도와 마지막 관측 시각도 따져야 합니다. 모호하면 다시 보거나 사람에게 확인하는 절차가 필요합니다.
화면에서는 표적이 가려지면 실행할 행동이 0개가 됩니다. 지시한 좌표 자체는 그대로 남습니다. 목표를 정한 것과 실행 허가를 나눠 보여 주는 것입니다. 가림 여부는 사용자가 선택하며 실제 영상에서 자동 판별하지 않습니다.
원리 03
작은 연결 모형에서 알 수 있는 범위
진짜 VLA 모델은 학습한 자료와 로봇의 행동 표현에 영향을 받습니다. 단어를 처리해도 손의 관절 한계, 물체의 무게, 작업 범위를 넘을 수는 없습니다. 언어 능력과 몸으로 일을 마치는 능력을 따로 평가해야 합니다.
이 실습은 작성된 규칙을 따라 선택합니다. 새로운 문장을 이해하거나 컵과 상자를 구별하지 않습니다. 두 지시를 잘 실행했다는 결과로 실제 AI의 일반화 성능을 주장할 수 없습니다. 관측이 부족할 때 행동을 보류하는 연결 구조만 살펴봅니다.
숫자로 천천히 따라가기
위치는 알지만 움직이지 않는 경우
아래 숫자는 이 강의 실습의 교육용 예시입니다.
- 오른쪽 상자를 집으라는 지시를 고릅니다.
- 규칙에 따라 표적 위치가 +0.5 m로 정해집니다.
- 표적이 가려짐을 고르면 표적 관측은 0개입니다.
- 실행할 행동도 0개가 되어 정지합니다.
알고 있는 목표와 지금 확인한 정보를 구별해야 성급한 행동을 줄일 수 있습니다.
이렇게 오해하기 쉬워요
흔한 생각 자연어 버튼이 있으므로 실제 AI가 문장을 이해한다.
선택 문장과 좌표를 사람이 직접 연결한 교육용 규칙입니다.
흔한 생각 어디로 갈지 정해졌으면 반드시 움직여야 한다.
실행에 필요한 관측이 부족하면 확인을 먼저 할 수 있습니다.
오늘 가져갈 세 문장
이것만은 기억해 주세요
- 지시의 대상과 기준을 먼저 명확히 합니다.
- 관측 부족을 드러내는 동작도 중요합니다.
- 언어 처리와 물리 작업 성공은 별도로 시험합니다.
강의 설명과 적용
VLA는 시각과 언어 정보를 행동에 연결하는 모델 접근입니다. Google DeepMind의 RT-2는 웹 기반 지식과 로봇 데이터를 연결하는 연구 사례로 소개되었습니다.
모델이 언어를 처리한다는 사실이 물리적으로 가능한 모든 일을 한다는 뜻은 아닙니다. 사용할 로봇의 행동 표현, 센서와 학습 작업 범위가 실제 수행을 제한합니다.
컵이 둘이거나 목적지가 지정되지 않으면 지시가 모호합니다. 행동 전에 대상을 확인하거나 안전하게 멈추는 규칙은 자연어 입력 기능과 별도로 설계해야 합니다.
평가에서는 본 적 있는 물체, 새로운 물체, 새로운 조합과 지시를 구분합니다. 특정 연구의 성과를 다른 하드웨어나 공장의 성공률로 옮겨 쓰지 않습니다.
3D 실습 과제
왼쪽 상자 지시를 고정하고 표적이 보이는 조건과 가려진 조건을 실행하세요. 이어 오른쪽 지시로 바꿔 선택 좌표와 정지 여부를 비교하세요.
준비된 지시 선택 시나리오입니다. 언어 모델 호출이나 실제 VLA 추론을 하지 않습니다.
관련 3D 실험 열기확인 문제
같은 색 컵 두 개에 “저 컵을 가져와”라고 했습니다. 우선 필요한 동작은?
- 임의로 하나 잡기
- 대상 식별을 확인하기
- 잡는 힘 증가
풀이 보기
모호한 대상은 힘이나 속도를 바꿔 해결할 수 없습니다.
출처와 확인 범위
Google DeepMind · RT-2 연구 발표
2023년 연구 발표의 영상·언어·행동 연결을 확인합니다. 연구 결과를 모든 로봇·현장에 일반화하지 않습니다.
출처 확인일: 2026-10-14